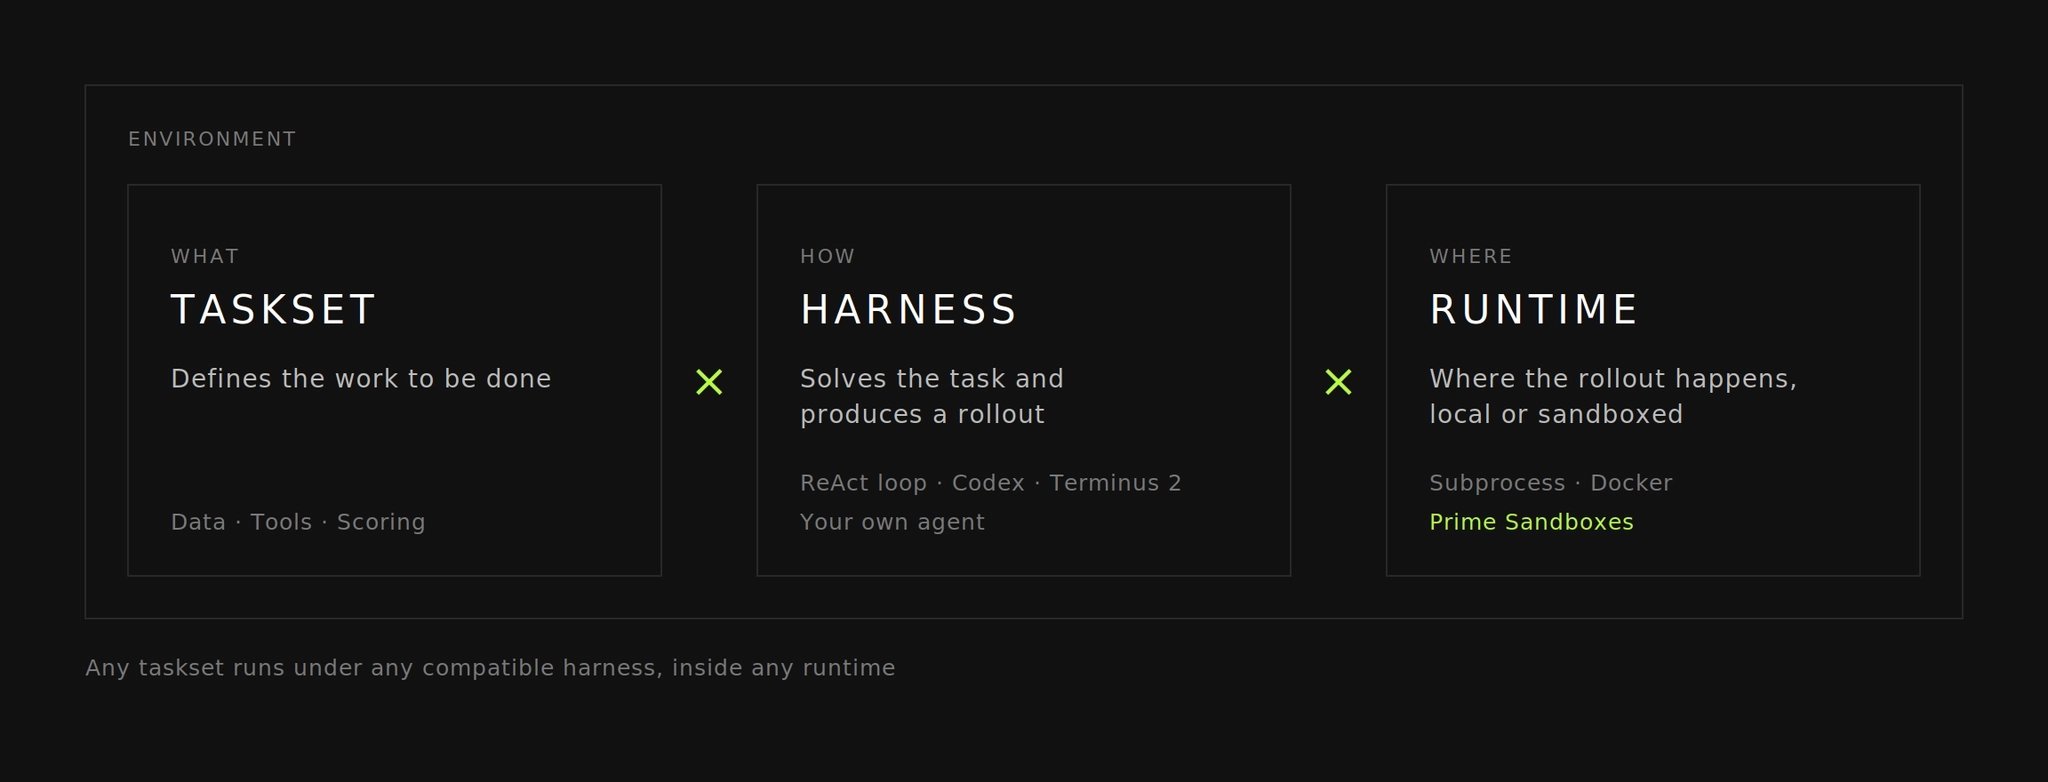
Prime Intellect 把 RL Agent 环境栈拆成 task / harness / runtime 三层,是开源 RL Infra 的「乐高化」尝试,让社区不必重造轮子就能接入自定义 Agent 评测与训练。
产品是什么
Prime Intellect 发布 verifiers v1,本质是一次对 Agent 强化学习(RL)环境栈的架构重构。旧版本里 task、prompt、tool、reward 全部耦合在一个 Trainer 进程里,做新任务要改一大坨代码;v1 把栈清晰拆成三层:Task 数据集(题目 + 评测逻辑)、Harness(Agent runtime,管 tool 调用、上下文、多轮对话)、Runtime(sandbox 执行环境,隔离 + 资源管理)。三层通过标准 schema 解耦,可以独立迭代、独立替换。
解决了什么问题
RL for Agents 这两年的最大瓶颈不是算法,是环境。SFT 时代有 HuggingFace 数据集一把梭,但 RL 阶段你需要一个能跑 Agent rollout、能打分、能耗得起万级并发的环境栈。此前社区方案要么太简陋(自己写 Docker + parser),要么太封闭(OpenAI / Anthropic 的内部 harness 不开源)。verifiers v1 直接对标的是 <
继续阅读深度解读 + 编辑加注
下方还有 3-5 段深度分析 + Vincent 编辑加注 + 可点击信源,仅 Pro 会员可见
¥99 / 季 · 每周 1 篇深度研报 · 飞书+微信群双通道
已是 Pro 但仍被提示?联系反馈
- Prime Intellect 发布 verifiers v1 公告 · 2026-07-12
- Prime Intellect 官方文档 verifiers v1 · 2026-07-12
- Prime Intellect: decentralised AGI compute network · 2026-07-12